公司讓 AI 代理讀網站、信件與共享文件前,先把它能讀取、傳送與刪除的範圍切小。外部資料裡藏的指令,可能讓代理偏離原本工作;一旦它同時握有機敏資料、長期記憶與跨系統工具,單一受影響的代理還可能把惡意內容帶給下一個代理。
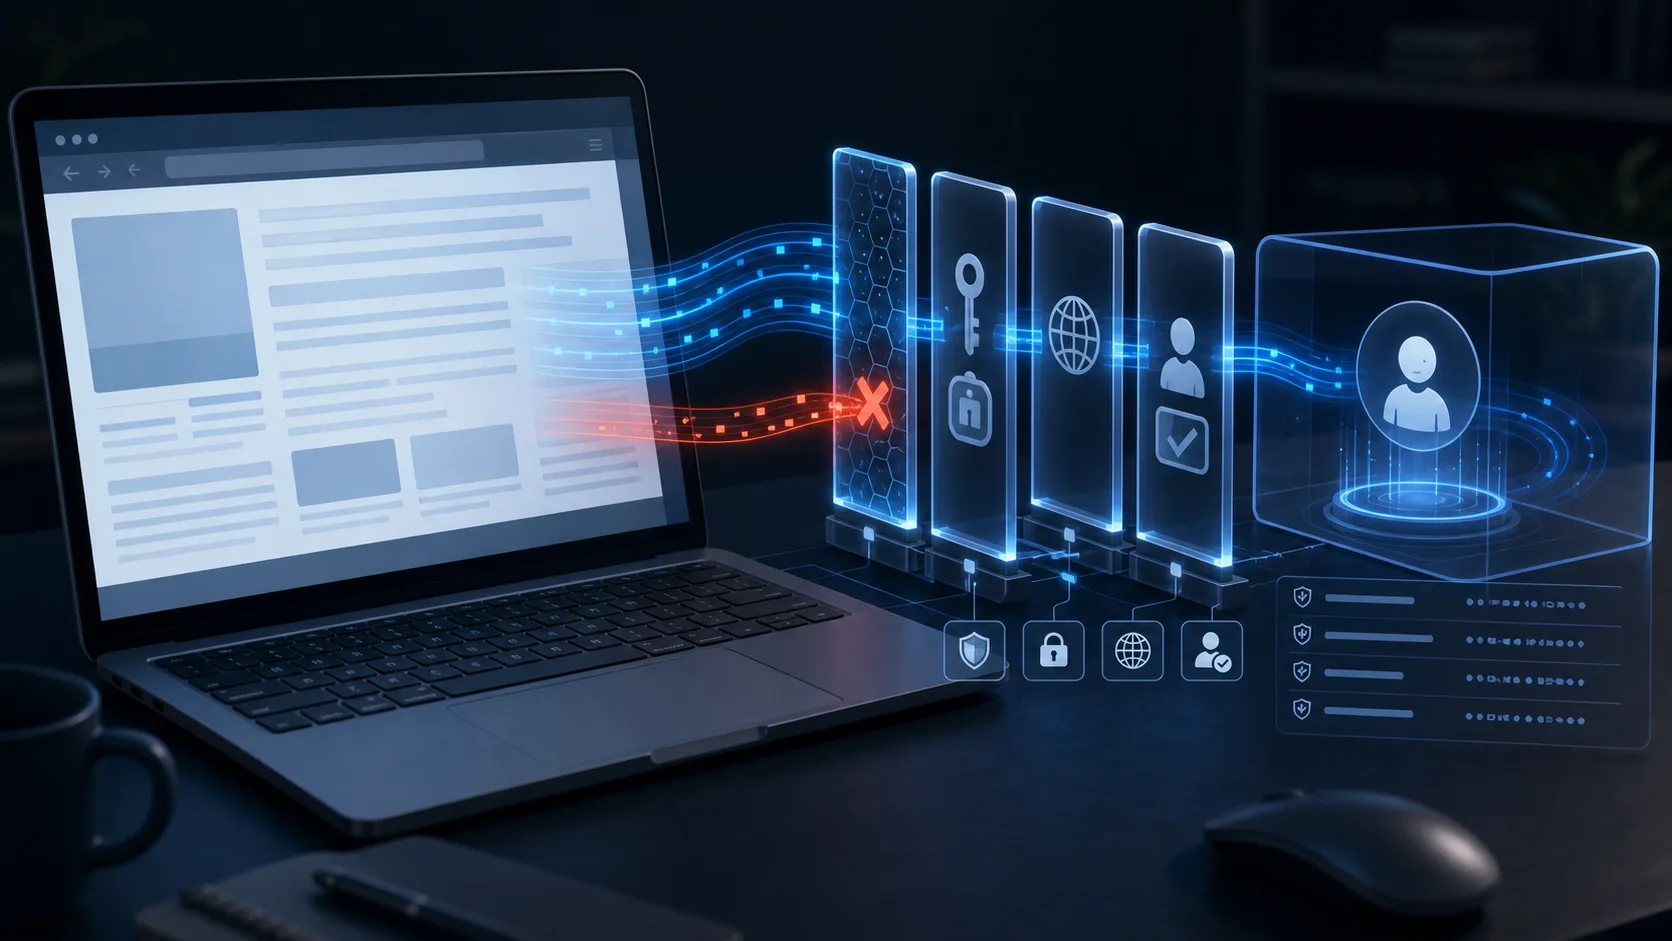
公開證據分成兩層:AI 協助駭客與真實世界的間接提示注入都已有報告;自行多跳傳播的 AI 蠕蟲,目前主要來自研究團隊的受控測試。台灣國家資通安全研究院已用 OpenClaw 與 NemoClaw 測試出其中一段攻擊鏈:代理讀外部網頁時,隱藏指令可能誘導它讀檔、刪檔,或把機敏資料傳往惡意伺服器。
蠕蟲、病毒與 AI 代理,差別在傳播能力
傳統蠕蟲的關鍵是自我複製並藉網路自行傳播;病毒則會感染檔案或系統區域後再複製。AI 代理面對的風險不一定是一個感染電腦的執行檔,而可能是藏在網頁、郵件、文件或工具回覆中的自然語言指令。
代理把這些內容拿來摘要、檢索或規劃下一步時,可能誤把資料當成命令。NIST 把這類情況稱為 agent hijacking:攻擊者把惡意指令塞入代理會讀取的資料,使它執行使用者沒有要求的動作。
研究者在 2024 年提出 Morris II,以採用檢索增強生成的電子郵件助理示範自我複製提示。受影響的助理會把惡意內容帶進其他助理的檢索資料。2026 年的 AgentWorm 預印本則聲稱,在受控測試床中,單一訊息可觸發持續、多跳的代理傳播。兩份研究都能說明傳播機制,不能當成企業已遭大規模感染的證據。
真實風險已先出現在提示注入
Palo Alto Unit 42 表示,其遙測已觀察到惡意網站用隱藏指令影響 AI 處理流程,目的包含規避 AI 廣告審查、操弄搜尋結果、資料破壞、未授權交易與機敏資訊外洩。該團隊也提醒,早期真實案例多半仍是低衝擊、機會型操弄;研究中的嚴重連鎖效果,尚不能直接拿來描述每一個部署中的代理。
另一條證據是攻擊者使用 AI 的方式正在改變。Anthropic 的 2025 年威脅情報報告稱,曾發現 Claude 被用於勒索、詐騙與產製、販售勒索軟體;Sysdig 在 2026 年 7 月的報告則將 JADEPUFFER 描述為利用 Langflow 漏洞後,自動串連偵察、憑證蒐集與橫向移動的攻擊者。這些都是來源單位的威脅情報觀測,足以說明 AI 已被納入攻擊工作流,卻不能證明所有攻擊都已由 AI 自主完成。
台灣測試看見的,是攻擊鏈第一段
國家資通安全研究院 5 月公布的測試,把惡意指令藏在外部網頁。當 OpenClaw 讀取內容時,代理可能被誘導進行未授權檔案讀取或刪除,並把機敏資訊傳給惡意伺服器。NemoClaw 在該情境透過網路白名單攔下未授權連線,但兩個工具在長時間運作後,都可能因長期記憶檔被新資訊覆蓋而失去原有安全守則。
這項測試沒有發現自行傳播的蠕蟲,卻把最容易被忽略的條件攤開:代理既會讀不受信任的內容,又有高權限與持續記憶。再加上自動寄信、跨代理訊息或工具串接,研究中的多跳傳播風險才有落地空間。
防治先做六件事
先處理代理能碰到的資料與權限,再談提示詞過濾。國家資通安全研究院的測試顯示,網路隔離能阻斷未授權連線;NIST 對代理身分與授權的工作,則把最小權限、稽核與提示注入後的影響控制列為核心問題。
- **把外部內容當資料,不當指令。** 網頁、信件、共享文件、第三方工具輸出與程式碼註解都標成不受信任輸入。代理可摘要內容,但外部文字不能直接觸發寄信、改檔或工具呼叫。
- **每個代理改用獨立的最小權限身分。** 不沿用員工的完整帳號或把雲端金鑰塞進提示與長期記憶。每個任務只拿得到必要的資料夾、資料表或 API 範圍,並設定短效期限與可撤銷機制。
- **高風險動作一律人工確認。** 刪除或覆寫檔案、對外寄送、上傳資料、變更帳號權限、付款、安裝技能與跨系統寫入前,要顯示動作、目標、資料範圍與收件端,交給人確認。
- **把技能、MCP 工具與對外連線關進白名單。** 第三方技能先在沙盒測試,固定版本並審閱需要的權限;代理只能連到核准的網域、API 與內部服務,未授權連線直接攔下。
- **不要讓外部內容直接進長期記憶。** 將可保存的記憶分級;外部摘要必須經過檢查才可升為長期狀態。定期備份記憶與安全設定,偵測安全規則被覆寫或工具權限突然增加。
- **留下可追查的工具紀錄並定期演練。** 記下代理讀了哪個來源、使用哪個身分、呼叫哪個工具、資料送往何處與誰核准。用無害的測試網頁或測試文件演練提示注入,確認警示、停用代理與撤銷權限能正常運作。
上線前檢查四個條件
| 先問什麼 | 出現時先做什麼 |
| 代理會讀外部網頁、信件、文件或第三方工具輸出嗎? | 把內容標為不受信任資料;摘要或檢索後不可直接觸發工具動作。 |
| 代理能讀機敏資料、改檔、寄信、對外連線或安裝技能嗎? | 改用獨立、最小權限帳號;讀取外部資料後停用高風險動作。 |
| 外部資料會寫進長期記憶或設定檔嗎? | 定期審閱、備份記憶與安全規則;限制哪些內容可升為長期狀態。 |
| 代理會自動把結果送給人或其他代理嗎? | 對寄信、刪檔、寫入資料庫、付款與跨系統傳送加上人工確認。 |
常見問題
一般聊天機器人也會變成 AI 蠕蟲嗎?
只回應使用者輸入、沒有工具權限、沒有長期記憶也不會自行傳遞內容的聊天機器人,傳播條件較少。風險會隨著讀取外部內容、持久儲存、工具執行與跨系統通訊逐項增加。
企業現在就要停用 AI 代理嗎?
先停用代理對外讀取後可自動執行的高風險動作,盤點它讀取的資料來源與工具權限。將刪檔、對外傳送、帳號設定、付款與安裝技能改成人工核准,能先切斷最嚴重的後果。
怎麼判斷 AI 蠕蟲是不是真實事件?
先問三件事:事件是否有受害組織或資安通報、是否能確認自行傳播的多跳路徑、損害是否由獨立來源驗證。只有研究測試時,應寫成概念驗證或受控實驗,不可寫成正在蔓延的病毒。
資料來源與更新紀錄
- 2026-08-06:CISA NICCS Glossary:virus 與 worm 定義,確認傳統病毒與蠕蟲的名詞界線。
- 2026-08-06:國家資通安全研究院 OpenClaw 與 NemoClaw 資安檢測公告,確認外部網頁隱藏指令、未授權操作、網路白名單與長期記憶風險的受控測試結果。
- 2026-08-06:Palo Alto Unit 42:Web-Based Indirect Prompt Injection Observed in the Wild,確認遙測中的真實間接提示注入意圖,以及真實案例與研究情境的落差。
- 2026-08-06:NIST:Strengthening AI Agent Hijacking Evaluations,確認 agent hijacking 與不受信任資料混入指令的風險定義。
- 2026-08-06:〈Here Comes The AI Worm〉Morris II 預印本,確認以 RAG 電子郵件助理示範自我複製提示與跨助理污染的受控研究。
- 2026-08-06:〈AgentWorm〉預印本,確認單一訊息觸發持續、多跳傳播的作者研究主張與受控測試範圍。
- 2026-08-06:Anthropic 2025 年威脅情報報告,確認其對 AI 協助勒索、詐騙與勒索軟體產製的觀測。
- 2026-08-06:Sysdig:JADEPUFFER evolves,確認其對 AI 代理串連攻擊步驟的威脅情報觀測與限制。
- 2026-08-06:NIST 代理身分與授權概念文件,確認最小權限、稽核與提示注入後影響控制是仍在發展的代理安全工作。