OpenAI 8 月 1 日首度確認下一代模型 Astra,並公開它在數學與理論電腦科學完成的十項研究成果。OpenAI 同時公布一條完整工作流程:Astra 先產生新的數學論證,人類研究人員再與同一模型整理成 249 頁論文,最後由模型把每套論證改寫成 Lean 形式化證明,交給電腦逐步檢查。
十個題目橫跨高維幾何、編碼理論、群論、算子代數、量子複雜度、格密碼學與極值組合學。OpenAI 表示,這些問題的主要結果至少十年沒有進展,多數停滯時間更長。Astra 目前仍是內部模型,OpenAI 尚未公布模型架構、訓練方法、正式名稱、開放時間與使用價格。
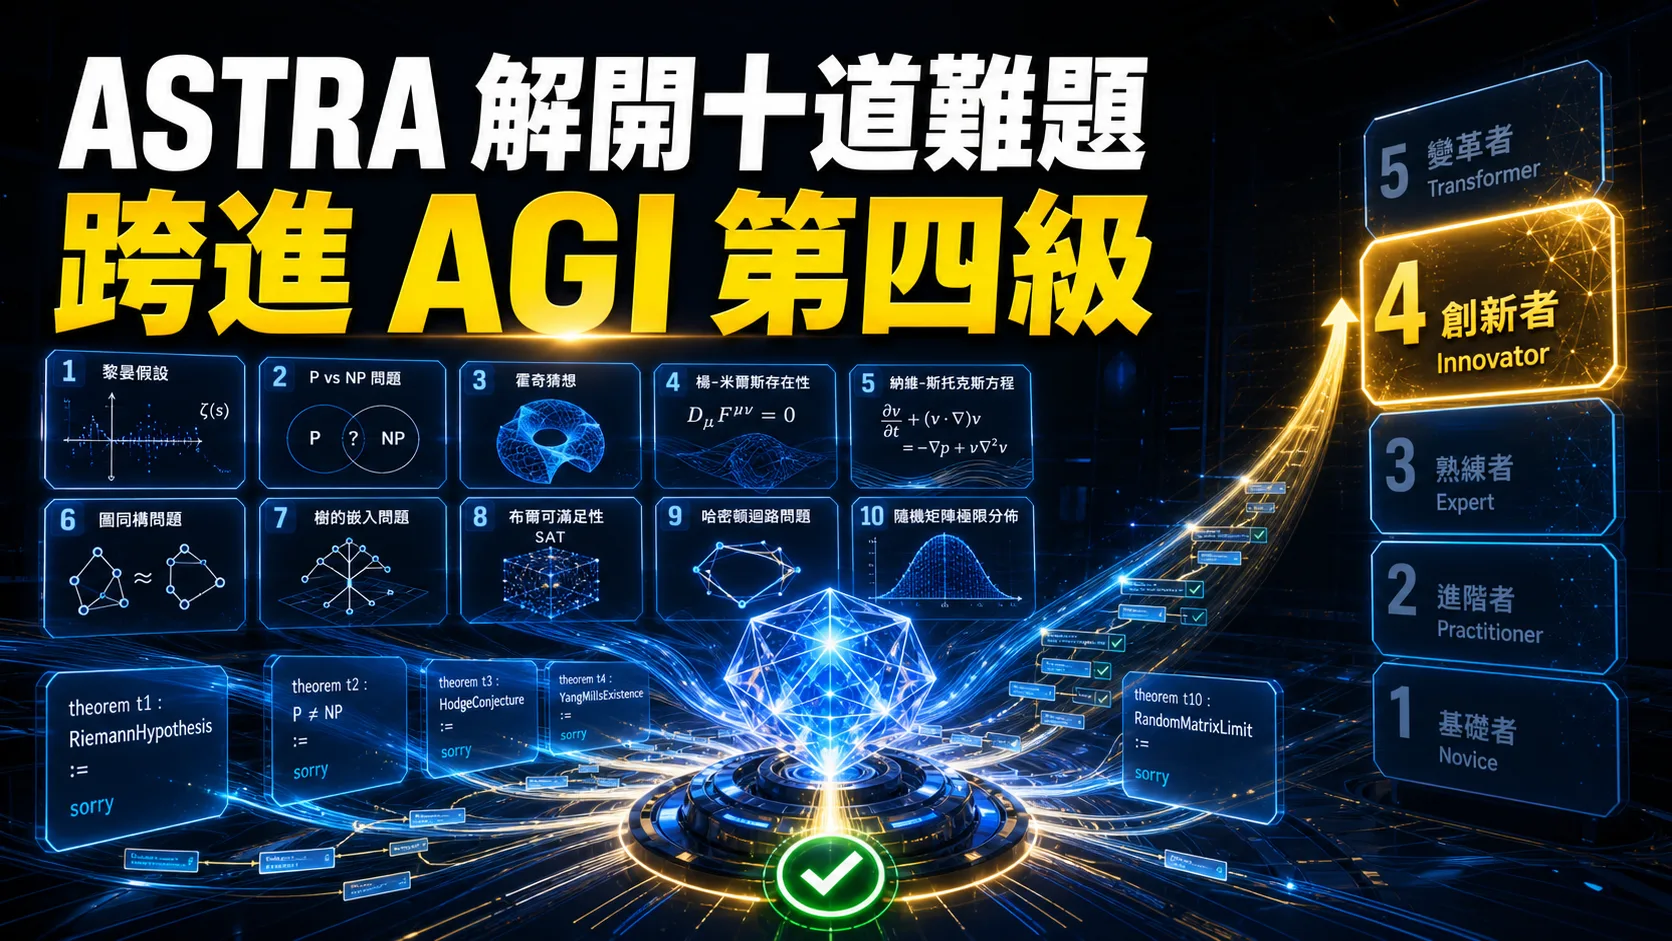
若使用 OpenAI 曾提出的五級 AGI 能力框架評估,Astra 在數學與理論電腦科學已跨進第四級「創新者」:系統開始產生人類原本沒有的新知識。它尚未展現跨越多數職業的穩定能力,也沒有公開獨立的長任務成功率。依 OpenAI 自己對 AGI 的定義,Astra 還缺少「能在多數具經濟價值工作上超越人類」的廣度與可靠性。
| 項目 | 已公開內容 |
|---|---|
| 模型 | OpenAI 下一代模型 Astra 的內部版本 |
| 研究任務 | 十項長期未解的數學與理論電腦科學問題 |
| 第一階段 | Astra 產生新的證明、反例、上下界或數學構造 |
| 第二階段 | 人類研究人員使用同一模型,把論證整理成可閱讀的論文 |
| 第三階段 | 模型將每套論證形式化為 Lean 證書 |
| 公開材料 | 249 頁論文、62 頁推理重建文件、十套 Lean 4 程式碼 |
| 運算費用 | OpenAI 估算尋找這十項解法所用 token,按 Sol API 費率約 2,000 美元 |
| AGI 位置 | 在形式化研究領域碰到第四級「創新者」,尚未達到跨多數工作的通用能力 |
| 仍未公布 | 模型架構、訓練資料、總嘗試題數、失敗次數、完整人工介入紀錄與正式上線日期 |
Astra一次處理十個跨領域研究問題
這十項成果包含證明、推翻猜想、建立反例與改善已知上下界。高維球體堆積項目提出 1978 年以來首度改善的一般指數界;非 sofic 群項目給出明確構造,處理群論延續多年的核心問題;Connes 剛性猜想項目建立反例;最接近向量問題則涉及後量子密碼學使用的格問題。
其餘成果還包括二元與球面編碼的新界、算術電路複雜度下界、一般雙人量子賽局的平行重複定理、Ehrhart 體積猜想、多色 Ramsey 數,以及兩項極值圖論猜想。這些成果需要不同領域的定義、既有定理與證明技術,Astra 因此展現的能力超出單一考試或同一類題目的大量作答。
OpenAI 先前在 5 月公開同一模型世代推翻 Erdős 單位距離猜想的成果。當時外部報導聚焦於模型能維持長推理鏈,並把幾何、組合學與漸近分析的工具接在同一套證明中。這次一次公開十項成果,顯示 OpenAI 已把研究級數學問題納入模型開發期間的固定評估。
第一階段由模型探索證明與失敗路線
OpenAI 對 Astra 的神經網路架構沒有提供技術說明,已公開資料主要揭露它如何執行研究任務。公司將長期未解問題交給內部模型,模型嘗試不同數學工具、檢查中間結論,遇到障礙後更換觀點,直到形成完整論證。
隨成果發布的 62 頁文件,記錄每項證明如何成形。這份文件由另一個模型讀取原始推理紀錄、正式論文與說明材料後重建,內容包含早期方向、失敗方法、改變觀點的時刻與最後採用的核心構造。文件提供的是事後重建版本,呈現出 Astra 接近持續搜尋的工作方式:先提出路線,再用條件、反例與既有定理排除無法成立的方向。
以高維球體堆積為例,早期方法嘗試用全域範數估計控制結果,但無法保留負值出現的位置資訊。後續路線把問題改寫為傅立葉特徵函數的局部質量問題,再透過 Mellin 轉換找出關鍵半徑。這種推理包含多次方法更換,和一次回答一道已知答案的數學題有明顯差距。
The Information 在官方發表前報導,Astra 的產品方向是讓多個 AI 代理人在背景平行工作,分解長時間、高難度任務,再共同整理結果;36 氪也轉述這項展示。OpenAI 的十項數學成果頁沒有說明每個證明是否採用相同的多代理人配置,因此目前可確認的是長鏈研究與形式化驗證流程,多代理人數量及分工仍以正式技術報告為準。
人類把模型論證整理成249頁論文
Astra 產生數學論證後,人類研究人員使用同一模型整理論文。這個環節要統一定義與符號、補齊引用、安排引理與定理的順序,並把探索過程改寫成領域研究者可以閱讀的正式文本。
OpenAI 對署名方式的說明也反映這項分工。公司表示,數學論證由系統產生,人類協助準備論文與形式化證明,OpenAI 對公布內容的正確性負責。這套做法把「提出核心證明」與「完成學術表達」分成兩個工作階段,也讓讀者能辨認模型和研究人員各自處理了哪些工作。
論文共 249 頁,每項成果都有摘要、主要定理、完整論證與參考資料。公開論文讓各領域研究者可以檢查定義、比較既有成果,判斷新結果是否真正處理原問題,以及其中哪些方法能延伸到其他研究。
Lean把每一步改寫成電腦可以檢查的證書
自然語言數學證明可能省略研究者認為顯而易見的步驟,也可能在符號、條件或量詞中留下細小錯誤。Lean 要求定義、前提與推導都以形式語言寫出;只要其中一步無法由既有規則推出,程式便不能完成編譯。
OpenAI 公開的 GitHub 程式庫為十項成果各準備一套 Lean 4 檔案,使用 Lean 4.32.0、mathlib 與 Lake 建置。外部研究者可以下載程式碼,執行 lake build All 檢查全部證明,也能用 Comparator 挑戰檔執行另一條獨立檢查流程。
這讓 Astra 的輸出形成兩種版本:249 頁論文提供人類可閱讀的數學解釋,Lean 證書提供機器可檢查的邏輯鏈。Lean 通過代表形式化後的定理能從指定前提與函式庫推出;研究成果的重要性、原創性,以及形式化敘述是否完整對應各領域原本關心的問題,仍由數學家閱讀論文、重建證明並進行同儕審查。
2,000美元只計算尋找解法的token
OpenAI 表示,找出十項解法所使用的 token,依 Sol API 費率換算約為 2,000 美元。這個數字顯示推理階段的邊際運算費用可能快速下降,但不能直接視為完成十項研究的總成本。
公開資料沒有列出模型一共嘗試多少問題、多少次執行失敗、研究人員如何篩選題目,以及人工整理論文、建立 Lean 環境與檢查形式化內容所投入的時間。模型訓練、資料中心、研究團隊與工具開發也不包含在 2,000 美元的 API 等值估算內。
社群對成本的反應因此分成兩部分。支持者看到的是研究級問題可以用低於傳統研究專案的單次推理費用大量探索;質疑者關心成功案例之前是否存在更大的題目池與失敗運算。OpenAI 若後續公布總嘗試量、每題運算分布與人工介入紀錄,才能進一步估算這套研究流程的成功率。
數學研究開始採用探索、整理與驗證三段分工
Astra 展示的能力可以拆成三段:模型大量探索證明方向,人類把可成立的論證整理成學界能閱讀的文本,形式化工具檢查每一步邏輯。模型同時參與探索、寫作與形式化,人類則負責選題、解釋、引用、領域判斷與研究責任。
數學特別適合率先採用這套流程,因為證明可以轉成形式語言,由 Lean 檢查推導。物理、化學與生物研究還要處理量測、實驗設計、樣本品質與現實環境,模型提出的解釋必須經過實驗資料支持。多倫多大學數學家 Jacob Tsimerman 接受《大西洋月刊》訪問時也把理論領域與實驗科學分開:數學和部分理論學科會較快受到影響,生物與實驗物理仍依賴現實測試。
對一般工作者而言,這套流程提供一個更實際的觀察方式。下一代模型的差異將逐漸表現在能否長時間維持任務、同時嘗試多條路線、把結果整理成交付物,再交給另一套規則或工具驗收。Astra 在數學研究中使用 Lean;程式工作可用測試與編譯器,資料分析可用查詢、公式與來源紀錄。缺少可自動驗收標準的任務,仍需要更多人工檢查。
Astra在數學領域碰到第四級「創新者」
OpenAI 2024 年曾在內部使用五級框架描述通往 AGI 的進度:第一級是能對話的聊天機器人,第二級是能處理人類程度問題的推理者,第三級是能採取行動的代理人,第四級是能協助發明的創新者,第五級則能承擔一個組織的工作。這套分級由 Bloomberg、Reuters 與 Axios 報導;全產業目前沒有共同採用的 AGI 標準。
Astra 的十項數學成果首次提供明確的第四級訊號。模型處理的題目沒有已知標準答案,交付內容包含新的構造、證明、反例與上下界,並留下論文和 Lean 證書供外部檢查。只要其中多項成果通過領域專家審查,Astra 在形式化數學研究中的角色就已超過第二級推理者,也比依照既定步驟執行的第三級代理人多了一項「產生新知識」能力。
| AGI能力 | Astra目前的證據 | 判斷 |
| 解決陌生問題 | 十項長期未解問題出現新證明、反例與上下界 | 數學領域已出現第四級訊號 |
| 長時間自主工作 | 媒體報導可讓多個代理人處理長任務;官方未公布每題執行時間與介入次數 | 能力方向明確,穩定性未知 |
| 自我檢查 | 模型把論證轉成 Lean 證書,外部可重新建置 | 形式邏輯可驗收,學術價值仍由專家判斷 |
| 跨領域遷移 | 成果橫跨多個數學與理論電腦科學分支 | 同屬可形式化的理論領域,尚未涵蓋多數工作 |
| 多數經濟工作 | 沒有公開辦公、醫療、製造、管理與現實操作的整體評測 | 未達 OpenAI 對 AGI 的公開定義 |
| 可重複可靠性 | 已公布十個成功結果,未公布總題數、失敗率與盲測結果 | 無法估算一般任務成功率 |
Astra 跨過的是「模型能否自行產生研究成果」這一道能力門檻。通往 AGI 還有三個缺口:同一能力要能轉移到大量不同工作;長任務要有可量化的穩定成功率;系統要能在缺少 Lean 這類嚴格驗收器的真實環境中發現並修正錯誤。
METR 以人類專家完成任務所需時間衡量 AI 代理人的可靠工作跨度,2026 年的公開評測已使用以小時計的軟體、機器學習與資安任務;該機構同時提醒,現有測試對超過 16 小時的估算仍不可靠。Astra 尚未出現在這類獨立長任務評測中,十項成功案例也沒有提供足以計算成功率的母體。
若把 AGI 看成「廣度、自治、創新與可靠性」四項能力同時成立,Astra 已在創新上向前跨一大步,在自治上提供早期訊號;廣度與可靠性仍缺少公開證據。它目前接近一名能在形式化研究中提出新成果的 AI 研究員,距離接手多數人類工作的通用系統仍有兩項主要缺口。
OpenAI 已用 Astra 展示下一代模型參與研究成果完整生產流程的能力。接下來的判斷依據很具體:十項成果能否經過各領域專家審查、Lean 程式碼能否由外部團隊重建,以及相同流程公開後能否穩定處理未經挑選的新問題。
資料來源與更新紀錄
- 2026-08-03:OpenAI:Ten advances in mathematics and theoretical computer science(2026-08-01),確認 Astra 名稱、十項成果、工作流程、費用估算與公開材料。
- 2026-08-03:OpenAI:Ten Advances 論文,確認 249 頁論文、各項主要定理與研究範圍。
- 2026-08-03:OpenAI:How the Ideas Came Together,確認 62 頁推理重建文件的製作方式、失敗路線與證明形成過程。
- 2026-08-03:OpenAI GitHub:ten-proofs,確認十套 Lean 4 形式化檔案、建置方式與 Comparator 檢查入口。
- 2026-08-03:36 氪:突發!OpenAI 下一代 AI 攻克 10 項數學難題,補充中文科技媒體整理與數學社群反應;文中評價不作為成果正確性的證據。
- 2026-08-03:The Information:OpenAI Previews Astra AI Model in DC,補充上市前展示中的長時間任務與多代理人方向。
- 2026-08-03:TechCrunch:OpenAI claims it solved an 80-year-old math problem,補充同一模型世代先前處理 Erdős 單位距離猜想的背景。
- 2026-08-03:The Atlantic:Something Weird Is Happening in Math,補充研究級數學能力、理論領域與實驗科學差異的專家觀點。
- 2026-08-03:OpenAI Charter,確認 OpenAI 對 AGI 的公開定義為能在多數具經濟價值工作上超越人類的高度自主系統。
- 2026-08-03:Axios:OpenAI nears reasoning-capable AI,確認 OpenAI 內部五級 AGI 能力框架及各級定義。
- 2026-08-03:METR:Task-Completion Time Horizons,確認長任務能力的衡量方法,以及超過 16 小時估算的現行限制。